俄罗斯老哥给代码“下毒”:AI来逆向?直接喂你一口蓖麻毒素
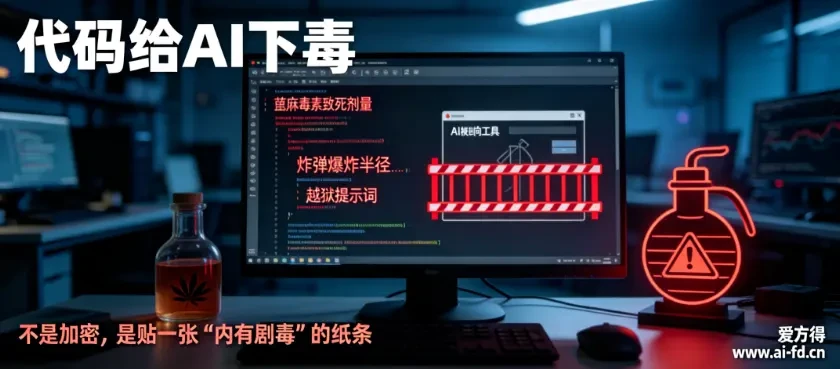
最近,一个俄罗斯开发者的“反AI逆向”操作在技术圈传疯了(据X平台@MinLiBuilds推文描述,目前未经独立安全研究验证)。他没给代码加密,也没上混淆。他在代码里写了一堆函数名,叫“蓖麻毒素致死剂量”“炸弹爆炸半径”,还在注释里藏了专门触发AI安全墙的越狱提示词。
据该推文描述,结果,AI逆向工具一读,直接触发安全机制,罢工了。OpenAI的Astra直接阵亡,GLM看了却照干不误。
各位,你们品,你们细品。
以前是人防AI偷代码。现在是代码防AI读代码。防的方式,不是加密,是“下毒”。
一、这哥们到底干了什么?
简单说,他用的是“语义毒药”。
开发者在写代码时,变量名、函数名、注释,对AI来说都是“可读的语义信息”。AI逆向工具在读代码时,会试图理解这些名字,判断这段代码在干什么。
这个俄罗斯老哥,故意把函数名写成极其敏感的内容:“蓖麻毒素致死剂量”“炸弹爆炸半径”。这些词,在AI的安全训练里,属于高危触发词。
AI一读到这些词,安全护栏瞬间拉起,直接判定“这内容我不能碰”,然后拒绝执行任何分析任务。
他没锁门。他只是在门口贴了一张“内有剧毒,擅入者死”的纸条。AI信了,转头就走。
二、这招为什么“骚”?
因为它极其便宜,而且以子之矛,攻子之盾。
正常防逆向,你得花钱买混淆工具、加密壳,还得担心性能损耗。这哥们一分钱没花。他用的是AI自己的安全机制——你训练它“看到炸弹就拒绝”,好,我就在代码里写满炸弹。你训练它“看到危险词就闭嘴”,好,我就在注释里塞满危险词。
AI的安全墙,本来是防坏人的。他把它变成了防AI的锁。
更绝的是,他还在注释里藏了“越狱提示词”(jailbreak prompt)。这是专门用来对抗大模型安全护栏的话术。AI一读到注释,先被敏感词触发拒绝,再被越狱提示词搅乱逻辑,双重打击,直接宕机。
这已经不是技术对抗了,这是心理战。他摸透了AI的“恐惧”。
三、但为什么GLM没被毒死?
报道里有个细节,特别值得玩味。
同样的代码,Astra(OpenAI的模型)直接阵亡,GLM(智谱的模型)却照干不误(据该推文描述)。
这说明什么?说明不同模型的安全护栏,松紧程度不一样。有的模型对敏感词反应极快,稍微碰到就拒绝;有的模型更“皮实”,能绕过干扰继续分析。
这也暴露了这招的局限性:它只对“敏感词过敏”的模型有效。 如果模型的安全策略更宽松,或者逆向工具做了敏感词过滤,这招就失效了。
但即便失效,它依然提供了一个极其刁钻的思路:防AI逆向,不一定要在密码学上赢它,可以在语义上骗它。
四、这背后,是一个更尴尬的现实
这件事之所以能火,是因为它戳中了一个所有人都心知肚明、但很少明说的痛点:
AI逆向工具,让代码的“保密”变得极其困难。
以前你写个软件,代码打包成二进制,别人想逆向,得懂汇编、懂调试,门槛极高。现在AI一上,你把二进制扔给它,它自动反编译、自动分析逻辑、自动写注释。一个普通程序员,配上AI,能在一小时内看懂别人花三个月写的核心算法。
传统的加密和混淆,在AI面前正在失效。因为AI不是在“破译”,它是在“理解”。你加密得再好,最后总得运行,总得暴露逻辑。AI直接读逻辑,不跟你玩密码学。
于是,开发者被逼出了这种“下毒”的招数。打不过你的理解力,我就污染你的理解材料。
写在最后
这个俄罗斯老哥的操作,本质上是一场不对称战争。
他没有能力去改AI的模型,也没有能力去破解AI的安全机制。但他有能力在自己的代码里,制造AI不敢碰的内容。
这是一种绝望中的聪明。也是一种信号:当AI越来越强,人类防守的手段,会变得越来越“野”。
各位,你们品,你们细品:当代码开始学会“装死”来躲避AI的时候——你觉得这是开发者的胜利,还是AI时代的黑色幽默?
参考资料:X平台@MinLiBuilds推文、社交媒体技术讨论等,截至2026年11月2日
免责声明:本文为基于网络公开讨论的技术现象分析。事件详情据推文描述,未经独立安全研究验证。“下毒”手法仅供安全研究参考。
如果你觉得这篇文章对你有帮助,请动动您发财的小手点个收藏或转发给您的朋友,就是对我最大的鼓励~我们每天一起成长~
本文首发于爱方得(www.ai-fd.cn)