国产GPU真刀真枪同台PK:天垓300现场反超H200,底气从哪来?
10月28日,上海。天数智芯的媒体开放日上,一台国产GPU和一台英伟达H200并排放着。没有PPT参数,没有理论峰值,直接跑现场。
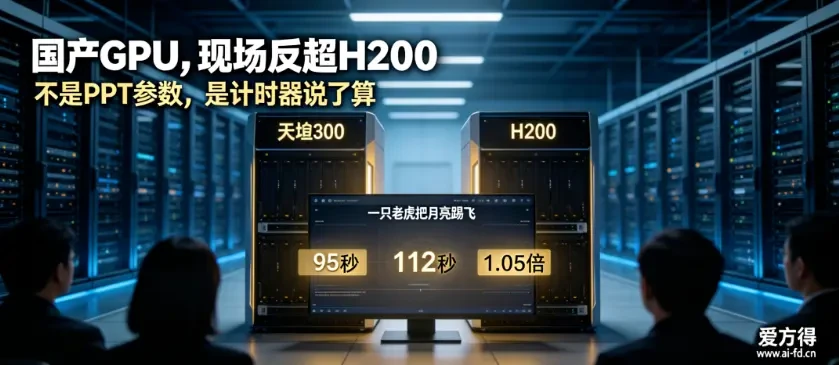
测试题目是随机选的——“一只老虎把月亮踢飞”。文生图,天垓300用了95秒,H200用了112秒。第三方实测,在典型大模型PD分离部署下,天垓300单卡端到端吞吐达到H200的1.05倍。
各位,你们品,你们细品。
这是国内首个在实测中把H200拉下马的通用GPU(据天数智芯方面说法/第三方实测)。不是“接近”,是“反超”。
一、95秒对112秒,赢在哪?
先看现场最直观的一组数据。
文生图场景,生成1920×1080分辨率的8张图,天垓300平均耗时95秒,H200是112秒。文生视频,天垓300的吞吐量达到0.628,同样高于H200。
但真正让业内人士坐直的,不是文生图快了几秒,而是第三方实测给出的那个数字:在典型PD分离部署下,天垓300折算单卡整体端到端吞吐达到H200的1.05倍。测试由上海仪电在今年7月完成,覆盖四大主流模型、三类场景。
注意,比的是“端到端吞吐”,不是理论峰值。 天数智芯自己说得很清楚:这里比的不是纸面算力,是在特定模型和部署条件下,整条推理链路的实际输出能力。
二、底气从哪来?三个“不按套路出牌”
敢和H200同台,光靠蛮力不够。天垓300的底气,藏在三个设计里。
第一,144GB显存,先装得下。
天垓300配备144GB显存,在长上下文和MoE模型成为主流的今天,显存就是吞吐量的天花板。装不下,算力再高也白搭。
第二,原生支持CUDA语义。
这是国产GPU最容易被忽略的一道坎。天数智芯的软件栈在命名上几乎是对着CUDA“一一对应”做的:ixCC对应nvcc,ixBLAS对应cuBLAS,ixDNN对应cuDNN。主流框架已完成适配,模型迁移成本被压到了最低。
第三,不单打独斗,搞异构。
天垓300的AFD分离方案,把Prefill阶段和Attention计算留给自己,把FFN专家网络交给合作厂商的XPU。实测解码推理延迟降低60%,是国内首个GPU与XPU异构部署跑通的方案。
说白了:一个人打不过,就组队打。
三、比“快”更重要的,是“算得值”
天数智芯这次开放日,反复提到一个词:Token工厂。
意思很直白:AI推理时代,客户不关心你芯片跑分多高,只关心每百万Token的成本是多少。
天垓300给出的答案是:IXL144超节点,单个标准机柜集成144颗GPU,聚合约10.1TB显存,业界密度最高。据测算,每百万有效Token成本比国际主流方案降低约40%。
这个数字比“1.05倍吞吐”更狠。性能反超是面子,成本打下来才是里子。
写在最后
当然,一场开放日的实测,不能等同于大规模商用验证。H200的生态壁垒、软件成熟度、长期稳定性,都是国产GPU还需要补的课。
但至少在这一天,在这个实验室里,一台国产GPU和一台H200并排放着,跑同样的任务,赢了。
不是靠PPT,是靠现场计时器。
各位,你们品,你们细品:当国产GPU开始用“每百万Token成本”而不是“理论算力”来定义自己的时候——你觉得英伟达该慌的,是性能,还是价格?
参考资料:新华财经、量子位、星岛环球网、InfoQ、IT之家、澎湃新闻、智东西、芯智讯、快科技等,截至2026年11月2日
免责声明:本文为基于公开实测数据的产业分析,不构成任何投资建议。
如果你觉得这篇文章对你有帮助,请动动您发财的小手点个收藏或转发给您的朋友,就是对我最大的鼓励~我们每天一起成长~
本文首发于爱方得(www.ai-fd.cn)