DeepSeek为什么开源?工程师乌镇摊牌:对手不是同行,是时间
11月3日,2026年世界互联网大会乌镇峰会。DeepSeek研究工程师高熙被问了一个问题:你们为什么要把辛辛苦苦研究出来的成果,开源出去?
他的回答只有一句话:"为了AGI。我们想要AGI更快到来。"
一家公司,把核心技术免费送人。不是因为钱多,是因为它觉得——等不起。
一、他说了一句很"狂"的话:对手不是同行,是时间
在AI竞赛里,大家默认的对手是谁?OpenAI、谷歌、阿里、月之暗面。所有人都在盯着对手的榜单、对手的融资、对手的下一代模型。
高熙换了一个坐标系。
他说,真正的对手不是其他大模型公司,是流逝的时间。 "时间才像是一个很难打败的对手,我们一定要争分夺秒将AGI带到身边。"
他甚至给了一个极其急迫的假设:"如果AGI本来是十几年之后到来,我会希望它能加速到一年后;如果本来是一年后,那我希望它明天就能到。"
这不是商业逻辑。这是倒计时逻辑。
二、为什么"开源"能加速?他的解释很实在
高熙给了一个非常具体的研发场景。
假设DeepSeek发现了一种更低的训练成本、或者更优的模型结构。摆在面前两条路:
第一条,闭源。 自己捂着,设壁垒,拦着对手追。短期看,领先优势保住了。
第二条,开源。 立刻公开,让所有人来讨论、验证、应用。
他选了第二条。理由极其冷静:"如果闭源设障阻拦竞争对手,短期看可能保持领先,但放长时间看,延迟的是全社会获得技术红利的时间。"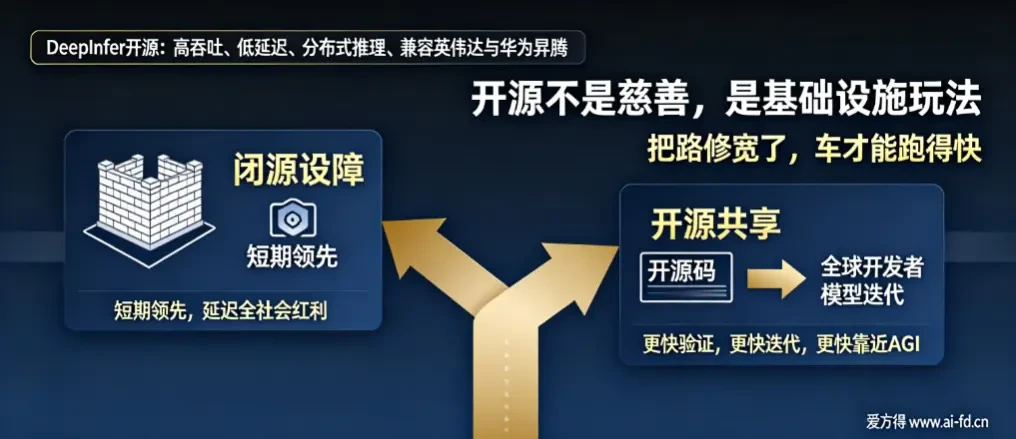
更狠的是他的操作逻辑:如果别人也解决了这个问题,DeepSeek就抓紧把技术用到自己的模型里;如果自己先解决了,就分享出去,推动整体进程往前挪一步。
"当AGI到来时,你不会在乎它究竟是哪个模型公司带来的。"
这句话,可能是整场对话里最不像商人说出来的话。
三、开源不是"做慈善",它有自己的算盘
当然,DeepSeek不是在做慈善。
10月20日,DeepSeek宣布将内部推理框架DeepInfer全面开源。 这个框架支撑着DeepSeek V4.1 Flash的高吞吐、低延迟推理服务,集成了分布式推理、推测解码、结构化输出等能力,兼容英伟达和华为昇腾平台。
官方给出的开源理由很务实:帮助开发者与企业优化推理的吞吐与延迟,降低算力成本、减少能源消耗,"让智能以更低的价格触达更广泛的人群"。
说白了:把推理框架开源出去,让更多人用得起大模型。用的人越多,生态越大,迭代越快。
这不是情怀,这是基础设施的玩法。跟当年谷歌开源Android、Meta开源PyTorch,底层逻辑是一样的:把路修宽了,车才能跑得快。
四、但他没有回避风险
 开源有没有问题?有。
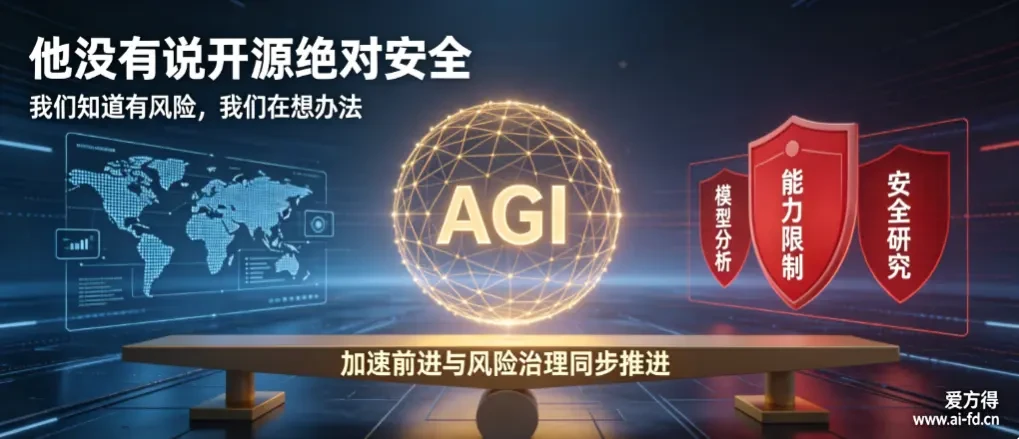
高熙在台上没有回避。他承认,开源"确实有可能会放大人工智能导致的安全风险"。模型不开源也有风险,但开源会让恶意滥用和模型本身的风险更容易扩散。
他的回应是:DeepSeek正在探索通过模型分析、限制部分能力等方式来应对。 相关研究还在推进,"一旦成熟将成为AGI发展的重要节点"。
他没有说"开源绝对安全"。他说的是"我们知道有风险,我们在想办法"。
五、写在最后
高熙在对话最后说了一句话,很朴素:"不忘初心、方得始终。希望人工智能从业者不要忘记最初的理想和目标。"
DeepSeek的开源逻辑,本质上是一场关于"优先级"的赌注:是先把对手甩开,还是先把终点拉近。
他们选了后者。
当一家公司把"AGI什么时候来"看得比"谁先做出AGI"更重要的时候,开源就不是策略,是加速器。
如果AGI真的会在几年内到来——你觉得它应该是一家公司的私有财产,还是全人类共享的公共品?
留一句给大家讨论:
你觉得开源是加速AGI的最好方式,还是把风险也一起加速了?
如果你身边也有"只看谁家模型跑分高"的朋友,把这篇转给他——比只讨论"谁更强"有用。
参考资料: 中国青年报、搜狐、网易、36氪、BAAI智源研究院、新京报、央视网、21财经、太平洋科技等,截至2026年11月5日。
免责声明: 本文为基于公开演讲内容与官方信息的产业分析,不构成任何投资建议。
如果你觉得这篇文章对你有帮助,请动动您发财的小手点个收藏或转发给您的朋友,就是对我最大的鼓励~我们每天一起成长~
本文首发于爱方得(www.ai-fd.cn)